Domain glaskolben.de kaufen?
Wir ziehen mit dem Projekt
glaskolben.de um.
Sind Sie am Kauf der Domain
glaskolben.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain glaskolben.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
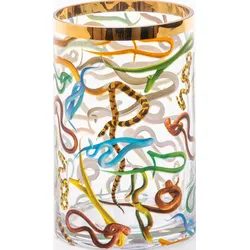
Toiletpaper Snakes Vase 14 cm ZylinderDie Vase der Marke Seletti aus der Serie Toiletpaper kann selbst eine Dekoration sein, auch wenn man vergisst, Blumen hineinzustellen! Er ist aus Glas und mit originellen Grafiken verziert, die für die Marke Seletti charakteristisch sind, die sich nie scheut, neue Wege zu gehen!70,18 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Alahmadi, Galal: Die Leere der VaseDie Leere der Vase , Gedichte - Deutsch-Arabische Ausgabe , Lenkungsstabilisatoren > Federung & Lenkung , Erscheinungsjahr: 202011, Produktform: Leinen, Autoren: Alahmadi, Galal, Übersetzung: Chammaa, Leila~Orth, Günther, Seitenzahl/Blattzahl: 201, Keyword: Asyl; Jemen; Abdulaziz-al- Maqalih-Preis; Krieg; Bürgerkrieg; Moderne; Afifi-Matar-Preis fu¨r Poesie; Verzweiflung; Flucht; Heimatlosigkeit; Lyrik, Fachschema: Jemen~Yemen~Arabien / Sprache~Arabisch, Fachkategorie: Einzelne Dichter~Belletristik in Übersetzung, Region: Deutschland~Jemen, Sprache: Arabisch, Thema: Entdecken, Warengruppe: HC/Belletristik/Romane/Erzählungen, Fachkategorie: Moderne und zeitgenössische Lyrik (ab 1900), Thema: Eintauchen, Text Sprache: ara ger, Originalsprache: ara, UNSPSC: 49111090, Warenverzeichnis für die Außenhandelsstatistik: 49111090, Verlag: Secession Verlag, Verlag: Secession Verlag, Verlag: Secession Verlag Berlin GmbH, Länge: 211, Breite: 139, Höhe: 20, Gewicht: 379, Produktform: Leinen, Genre: Belletristik, Genre: Belletristik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **


Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Datenquellen
-
Toiletpaper Snakes Vase 14 cm ZylinderDie Vase der Marke Seletti aus der Serie Toiletpaper kann selbst eine Dekoration sein, auch wenn man vergisst, Blumen hineinzustellen! Er ist aus Glas und mit originellen Grafiken verziert, die für die Marke Seletti charakteristisch sind, die sich nie scheut, neue Wege zu gehen!70,18 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Alahmadi, Galal: Die Leere der VaseDie Leere der Vase , Gedichte - Deutsch-Arabische Ausgabe , Lenkungsstabilisatoren > Federung & Lenkung , Erscheinungsjahr: 202011, Produktform: Leinen, Autoren: Alahmadi, Galal, Übersetzung: Chammaa, Leila~Orth, Günther, Seitenzahl/Blattzahl: 201, Keyword: Asyl; Jemen; Abdulaziz-al- Maqalih-Preis; Krieg; Bürgerkrieg; Moderne; Afifi-Matar-Preis fu¨r Poesie; Verzweiflung; Flucht; Heimatlosigkeit; Lyrik, Fachschema: Jemen~Yemen~Arabien / Sprache~Arabisch, Fachkategorie: Einzelne Dichter~Belletristik in Übersetzung, Region: Deutschland~Jemen, Sprache: Arabisch, Thema: Entdecken, Warengruppe: HC/Belletristik/Romane/Erzählungen, Fachkategorie: Moderne und zeitgenössische Lyrik (ab 1900), Thema: Eintauchen, Text Sprache: ara ger, Originalsprache: ara, UNSPSC: 49111090, Warenverzeichnis für die Außenhandelsstatistik: 49111090, Verlag: Secession Verlag, Verlag: Secession Verlag, Verlag: Secession Verlag Berlin GmbH, Länge: 211, Breite: 139, Höhe: 20, Gewicht: 379, Produktform: Leinen, Genre: Belletristik, Genre: Belletristik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Internationale Lagertitel, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0004, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Funk, Katharina: Vom Garten in die VaseVom Garten in die Vase , Schnittblumen aus dem eigenen Garten - das ganze Jahr. Mit Musterbeeten: saisonal & nachhaltig. Blumen pflanzen, pflegen und schneiden , > , Erscheinungsjahr: 20230120, Produktform: Kartoniert, Autoren: Funk, Katharina, Illustrator: Funk, Sebastian~Kuklinski, Farina, Seitenzahl/Blattzahl: 128, Abbildungen: 25 farbige Abbildungen, 135 farbige Fotos, Keyword: Beet anlegen; Beete pflanzen; Blumen; Blumen Geschenk; Blumen schneiden; Blumenbeet; Blumenbeet plane; Blumengarten; Blumenstrauß; Blüten; Cool Flowers; Dahlien; Einjährige; Floristik; Musterbeete; Rosen; Sommerblumen; Stauden; Strauss; Ziergehölze; Ziersträucher; Zweijährige, Fachschema: Garten / Kunst, Architektur, Design~Pflanze / Zierpflanze~Zierpflanze~Biogarten~Biologie / Biogarten~Garten / Biogarten, Fachkategorie: Gartendesign und -planung~Ökologisches Gärtnern, organischer Anbau, Warengruppe: TB/Garten/Pflanzen/Natur, Fachkategorie: Gärtnern: Blumen & Zierpflanzen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Franckh-Kosmos, Verlag: Franckh-Kosmos, Verlag: Franckh-Kosmos Verlags-GmbH & Co. KG, Länge: 250, Breite: 190, Höhe: 17, Gewicht: 490, Produktform: Klappenbroschur, Genre: Sachbuch/Ratgeber, Genre: Sachbuch/Ratgeber,20,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.